
Texto 100%
Ingeniería del ciclo de desarrollo agéntico
Cómo desarrollamos software con agentes en Collective AI
Cuando empezamos a entregar trabajo real con agentes de programación, escribir código dejó de ser una limitación. El agente es rápido y el resultado suele ser razonablemente bueno. Lo que empezamos a observar, en cambio, fue una deriva: dos módulos que deberían compartir una función auxiliar con bloques casi idénticos, un servicio que imprime en lugar de loguear, un límite devolviendo un dict crudo, una suite de tests en verde de un modo que nadie terminaba de creerse.
Nuestra primera respuesta fue la obvia: poner las convenciones por escrito. Un CONVENTIONS.md, una página en la wiki, un system prompt más largo. Eso ayudó, y sigue siendo nuestro punto de partida. Pero resultó ser un tipo de artefacto distinto del que terminamos construyendo, y la diferencia es mecánica, no editorial. Una lista de convenciones es contexto que un agente puede tener más o menos en cuenta para una tarea determinada. Un pre-commit hook que se dispara cuando el agente intenta hacer un commit —y devuelve un error que identifica la regla determinista que acaba de violar— no compite con nada más dentro de la ventana de contexto. La única forma de pasar es cumplir la regla.
Esa distinción define la forma de nuestro stack. Surge de una afirmación alrededor de la cual hoy organizamos nuestro trabajo: cuando baja el costo de escribir código, el cuello de botella se desplaza hacia dos cosas que siguen siendo difíciles: definir qué hay que construir y verificar que lo construido sea aceptable. Por eso, la mayor parte de nuestro esfuerzo está puesta en hacer que el estándar sea ejecutable, más que en redactarlo bien.
Este post describe lo que ejecutamos hoy: el loop, la cadena de definición, la capa de reglas, el runtime away from keyboard (AFK) y, por último, la secuencia concreta que seguimos en un repo, comando por comando.
1. El loop tiene tres etapas, y cada una tiene un responsable distinto
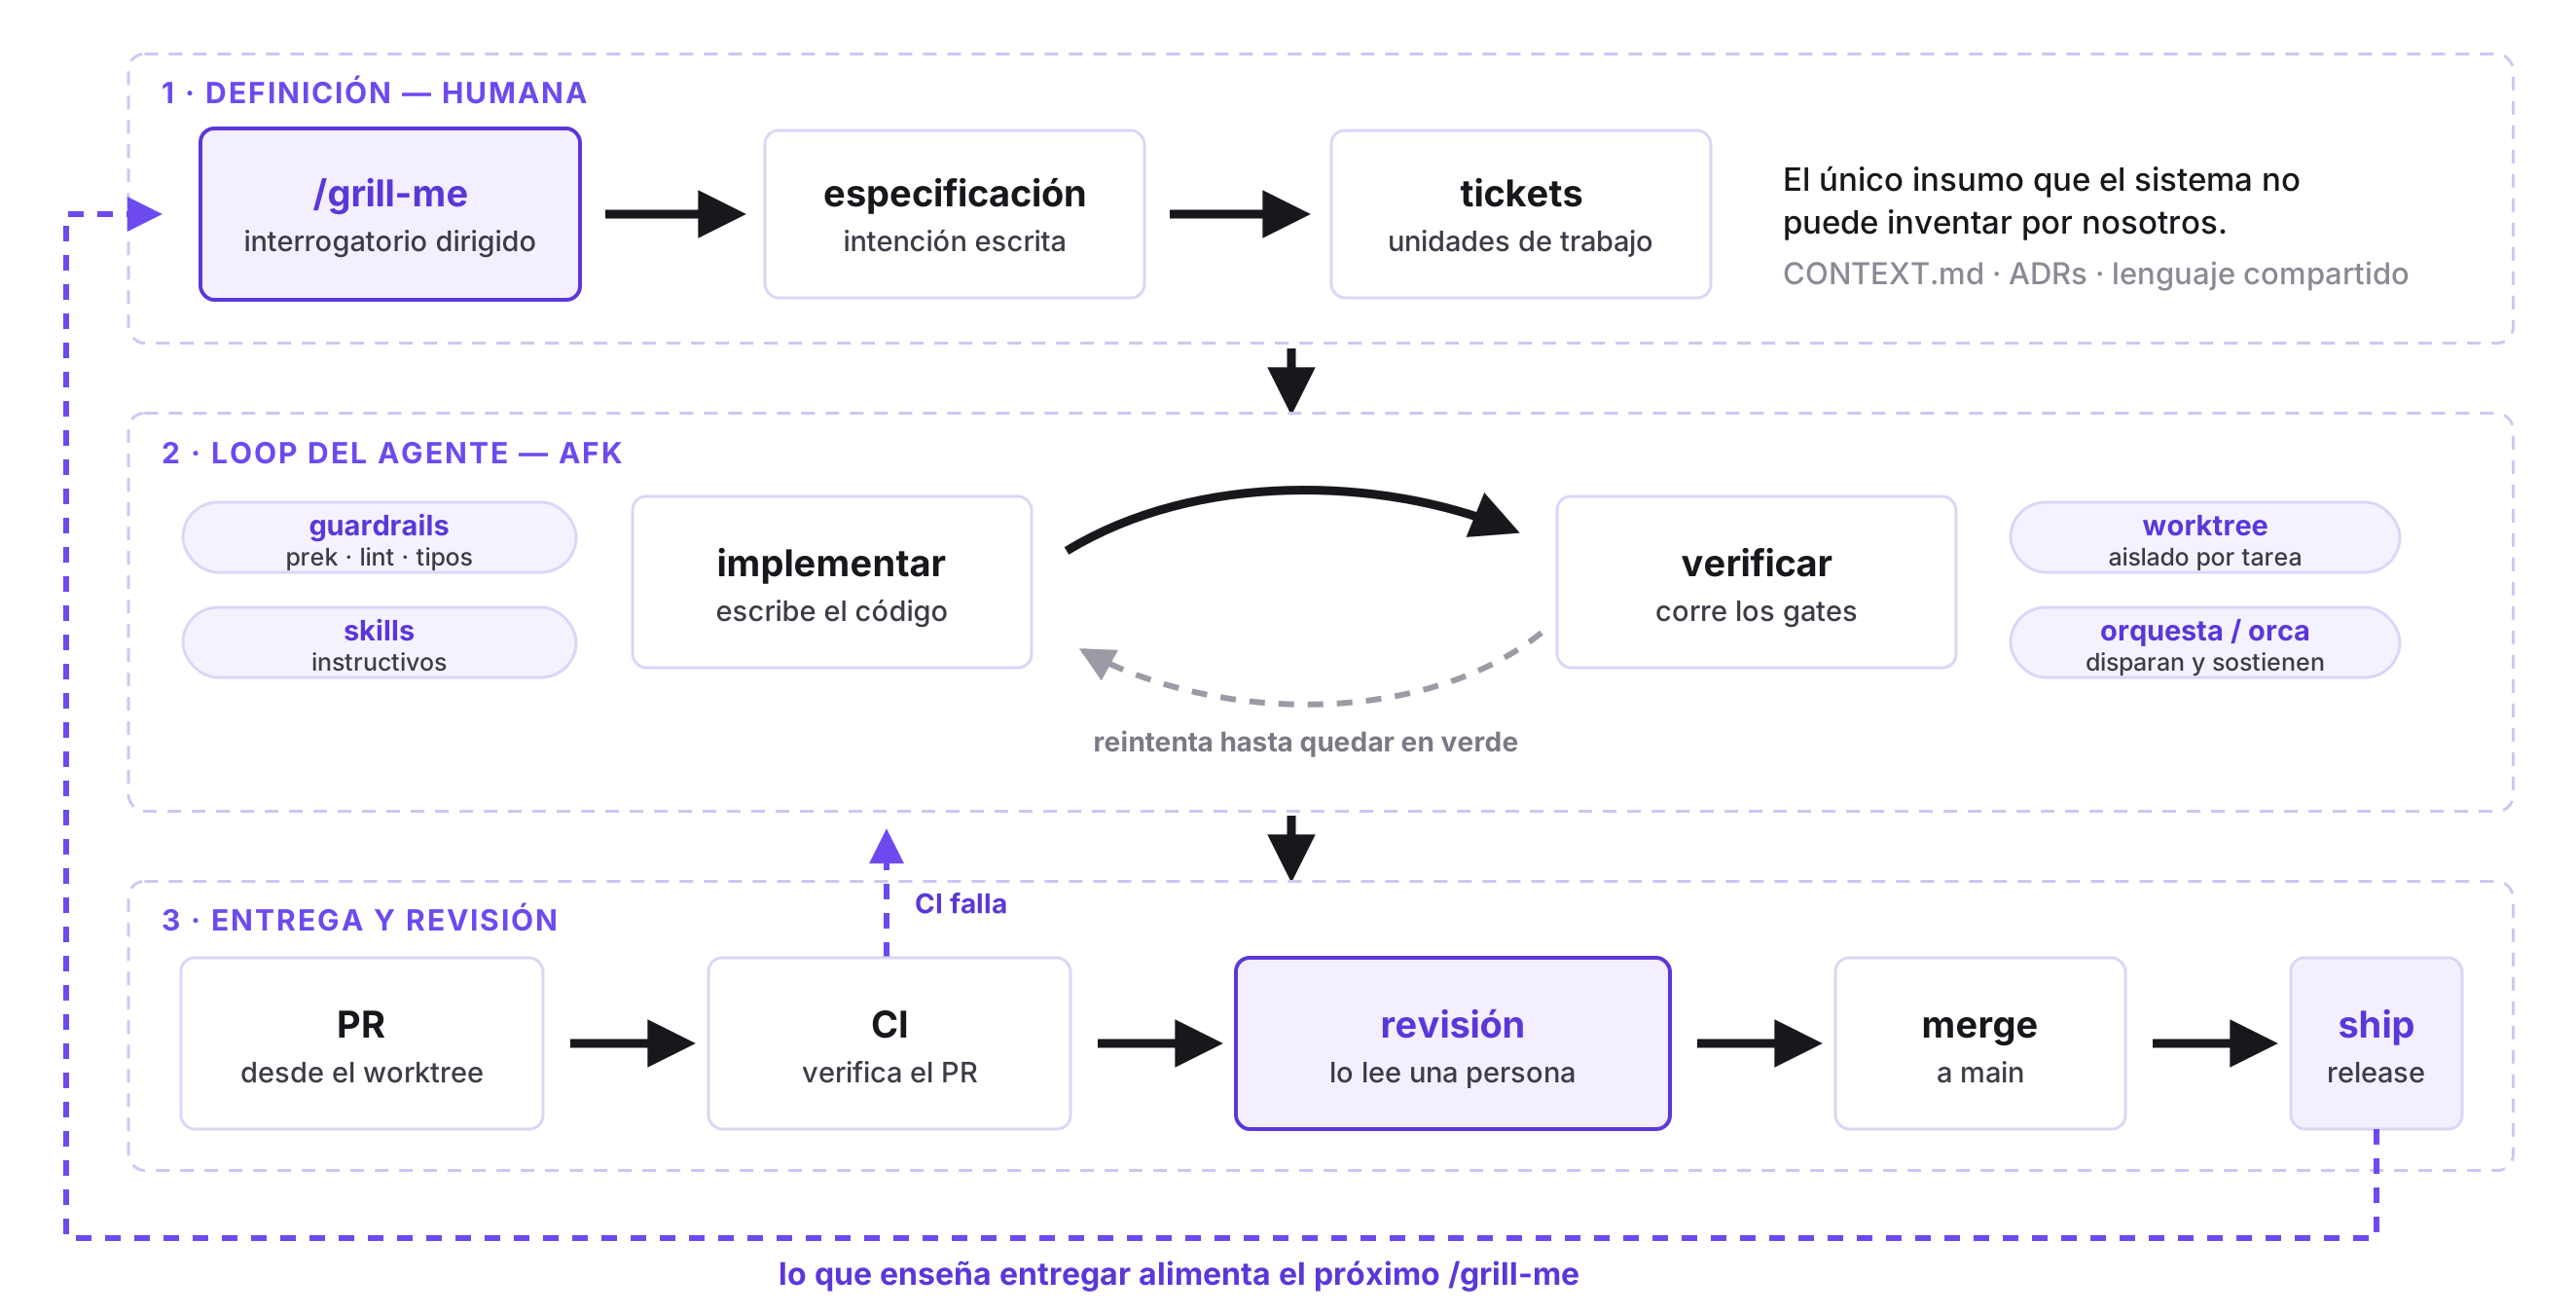
La definición es humana y no se delega. Es el insumo que el sistema no puede inventar por nosotros: qué se está construyendo y cómo sabremos que está terminado.
El loop del agente corre solo, contra los gates, hasta quedar en verde. Implementar, verificar, volver a intentar. No hay una persona dentro de ese círculo.
La entrega vuelve a pasar por una persona, pero sobre un artefacto acotado: un pull request.
El límite entre la primera etapa y la segunda es donde ponemos más atención. Si la definición es ambigua, el loop del agente se convierte en una máquina muy eficiente para producir mil líneas coherentes construidas sobre una premisa equivocada. Por eso, la definición es la etapa que más instrumentamos y, contraintuitivamente, lo hicimos haciendo que el agente nos hiciera preguntas a nosotros.
2. Definición: primero el interrogatorio, después los cortes verticales
El interrogatorio viene primero
El modo de falla al que volvemos una y otra vez nunca fue el código malo. Fue la desalineación: pensabas que la otra parte te había entendido, veías el resultado y descubrías que no. Los agentes no solucionan eso. Lo aceleran, porque un agente no discute un pedido insuficientemente especificado: completa los huecos en silencio y con confianza.
Así que invertimos la dirección de la conversación. En lugar de pedirle al agente que produzca algo, lo ponemos a interrogarnos: preguntas concretas sobre el cambio hasta que cada rama del árbol de diseño queda resuelta o explícitamente postergada. Para esto usamos las skills de Matt Pocock, y es la parte de nuestro stack que más rinde. De manera consistente, una hora de preguntas nos ha costado menos que un día de implementación en la dirección equivocada.
Hay tres puertas de entrada, y cuál elegir depende de lo que haya delante, no de una preferencia:
/grill-me— sin repo ni archivos. Una idea, una decisión, un cambio que puede resolverse en una sola sesión. Es nuestra opción predeterminada./grill-with-docs— la misma entrevista, pero trabajando contra la base de código y con estado: lee el repo y conserva lo aprendido enCONTEXT.mdy en ADRs./wayfinder— para un trabajo mayor que una única sesión con un agente. Organiza el trabajo como un mapa de tickets de decisión en el tracker y ejecuta sesiones de interrogatorio dentro de él, de modo que el mapa crece a medida que aparecen preguntas y se reduce a medida que se responden.
A partir de ahí, la cadena es deliberadamente aburrida, y cada eslabón tiene una sola función:
/to-spec— convierte la conversación en una especificación dentro del tracker. No vuelve a entrevistar: sintetiza lo que ya se discutió. Esa restricción es justamente el punto. Una especificación que vuelve a entrevistarte reintroduce supuestos que el interrogatorio ya había descartado./to-tickets— divide la especificación en tickets tipo tracer bullet, cada uno declarando qué otro ticket lo bloquea. Esa declaración es lo que después permite trabajar en paralelo sin que dos agentes colisionen.
Los ADRs y CONTEXT.md son productos del interrogatorio, no tarea pendiente
Lo que hizo que este enfoque realmente funcionara para nosotros es que el interrogatorio contra el repo escribe. Las decisiones se convierten en registros de decisiones de arquitectura (ADRs, por sus siglas en inglés); el vocabulario se convierte en entradas de CONTEXT.md. Ninguno de los dos es una tarea de documentación programada para más adelante: son el residuo de una sesión que ya ocurrió.
CONTEXT.md es el más barato de los dos y se rinde cada sesión. Su función es darle un único nombre a una idea recurrente, para que nadie tenga que volver a describirla desde cero. Pensemos en un curso compuesto por secciones y en una lección que solo cuenta como real una vez que fue escrita en el sistema de archivos. Sin un nombre, cada sesión vuelve a describir esa idea en una frase y media, y cada descripción deriva un poco: se vuelve real, se crea, queda escrita en disco. Con un nombre, es materialization, y esa palabra significa lo mismo en el ticket, en el nombre de la función y durante la revisión.
La ganancia no está en la brevedad. Está en que los nombres se mantienen consistentes entre módulos, funciones y archivos; el agente navega mejor por el repo; y deja de consumir contexto reconstruyendo jerga en cada inicio desde cero.
Los ADRs hacen la otra mitad del trabajo: evitan que el siguiente corte vuelva a discutir una decisión que el anterior ya resolvió. Cuando quien los lee es un agente, una decisión que solo existe dentro de una ventana de chat cerrada es una decisión que volverá a tomarse, y de manera diferente.
Dividimos verticalmente, y esta es la razón
Cuando dividimos una especificación en tickets, cada uno constituye un camino angosto a través de todas las capas que toca —un tracer bullet con un comportamiento observable al final—, en lugar de construir una capa completa para toda la funcionalidad. Nada de “agregar el modelo de datos”, “construir los endpoints” o “conectar la UI”.
No adoptamos este enfoque por las razones ágiles habituales. Lo adoptamos porque los cortes verticales son la única forma que encaja con el resto de la máquina:
- Un corte horizontal no tiene un criterio de aceptación que pueda ejecutarse. “Agregar la capa de persistencia” no puede comprobarse de punta a punta, por lo que los gates quedan en verde sobre código que ningún test ejercita. Un corte vertical termina en comportamiento, lo que significa que el loop del agente tiene algo concreto contra qué cerrar y que el paso de verificación está haciendo trabajo real, en lugar de limitarse a confirmar que el código compila.
- Un corte horizontal no puede revisarse de forma independiente. No hay nada para mostrar funcionando hasta que llega la última capa, así que la revisión ocurre tarde y toda junta. Los agentes reducen el costo de producir un
diff; no aumentan nuestra capacidad de leerlo. Cada corte tiene que poder integrarse de manera independiente. - Los cortes verticales colisionan menos. Dos agentes trabajando sobre “la capa de modelos” terminan peleando por los mismos archivos. Dos agentes responsables cada uno de un camino a través del sistema, en general, no. Y cuando sí ocurre, la dependencia de bloqueo está declarada en el ticket, de modo que la colisión se programa en lugar de descubrirse.
- Los tickets de decisión de Wayfinder son la misma idea, un nivel más arriba. Una pregunta cuya resolución es una decisión también constituye una unidad vertical: puede cerrarse.
Una regla práctica que repetimos bastante: si no podés escribir el criterio de aceptación, no tenés un ticket: tenés una intención. Un agente puede implementar un criterio. No puede implementar una intención; solo puede adivinar qué quisiste decir.
3. La capa de reglas: un estándar que se ejecuta
Distribuimos nuestras reglas internas mediante una pequeña CLI de bootstrap (Botica) que las instala en el repo de destino. Cada regla es un CES — Collective Engineering Standard, documentado en docs/engineering-standards.md, y la propiedad que importa es que un CES no es un párrafo. Es una de estas: un patrón de ast-grep, un hook de prek, una configuración de pyproject o una directiva de AGENTS.md acompañada por un archivo de detalle.
Dos identificadores, dos funciones
Cada regla tiene ambos:
| Capa | Valor | Se usa en |
|---|---|---|
| Código de catálogo | CES-<issue#> | El índice de AGENTS.md, referencias en commits y PRs, citas humanas, mensajes de incumplimiento |
| ID de máquina | slug en kebab-case (log-no-print) | id: de ast-grep, ID del hook de prek, .agents/rules/<slug>.md, # ast-grep-ignore: <slug> |
Cuando hay espacio, se escriben juntos: CES-46 · log-no-print.
El número nunca forma parte del slug. Los slugs son la clave que usan las herramientas y las supresiones, por lo que tienen que permanecer estables y ser semánticos aunque el issue cambie. Y el número proviene del issue en el tracker, lo que significa que los huecos tienen significado: una propuesta rechazada consume su número, al estilo PEP. Nada recibe un código por existir solamente dentro del código.
Tres niveles de contexto, a propósito
Una decisión de diseño que parece una convención de carpetas:
- Índice siempre activo — una sección
## Engineering Standardsdelimitada por marcadores dentro deAGENTS.md. Una línea por regla: directiva breve, marcador del mecanismo de aplicación y referencia. - Detalle bajo demanda —
.agents/rules/<slug>.md. Justificación completa, ejemplos, migración y mecanismos de excepción. - Código canónico —
.agents/snippets/. Fragmentos listos para usar en repos nuevos y plantillas de comparación para los existentes.
Mantenemos el índice en AGENTS.md en lugar de empaquetarlo como una skill porque, para los estándares horizontales —los que se aplican a todo el código, todo el tiempo—, el contexto pasivo y siempre presente cumple una función que la recuperación bajo demanda no puede cumplir. Una skill se invoca una vez que el agente decide que es relevante. Una regla de estilo tiene que estar presente antes de que el agente decida nada.
El marcador indica quién te detiene
Cada CES declara su mecanismo de aplicación, y el marcador no es decorativo:
| Marcador | Qué lo ejecuta | Ejemplo |
|---|---|---|
[ast-grep] | Patrón sintáctico, mediante prek y CI | CES-79 — no devolver dicts crudos en los límites: devolver, anotar o usar como alias una dataclass o un modelo de pydantic |
[prek] | Hook local, durante commit o commit-msg | CES-71 — file-size-guard: advertencia a las 400 líneas, error a las 700 |
[ci] | GitHub Actions; no puede omitirse | CES-119 — osv-scanner sobre el lockfile |
[dependency] | Se activa al instalarse, sin control separado | CES-111 — orden aleatorio de tests mediante pytest-randomly |
[snippet] | Código canónico que se copia | CES-74 — nuestro logger estándar de structlog |
[judgment] | Criterio del agente y del revisor | CES-5 — dirección de imports entre capas |
La última fila importa. No todo puede expresarse como un patrón y, cuando intentamos forzarlo, terminamos con reglas técnicamente aplicadas pero prácticamente inútiles. Las reglas [judgment] son honestas: necesitan un lector, y se limitan a ponerle el argumento delante.
Los mensajes de incumplimiento son autosuficientes
Un detalle pequeño con un efecto grande. El mensaje expresa su propia regla, la corrección y su código, nada más:
message: "CES-46 (log-no-print): libraries log, they don't print — use the house get_logger."
Lo que nunca debe hacer es nombrar una regla hermana ni indicar la clave de supresión de otra regla. La razón es el envenenamiento del contexto: repartir las políticas entre mensajes vecinos permite que una regla reformule —o silenciosamente reemplace— la decisión de otra, y el agente toma lo último que leyó como autoridad. La justificación conjunta vive exactamente una vez, en el archivo de detalle.
Nunca sobrescribir el repo
El instalador es clean-adds-only. Nunca edita ni sobrescribe un archivo existente. Todo lo que difiere se reporta como [defer] y queda para que una persona o un agente realicen el merge. No existe uninstall, porque la instalación requiere un repo de git: git checkout y git clean son el mecanismo para deshacerla.
Esa negativa a sobrescribir es precisamente lo que hace seguro ejecutarlo sobre un repo activo: la CLI se ocupa de la parte determinista y todo lo que requiere criterio —detección de repos nuevos frente a existentes, merges aditivos de JSONC, resolución de conflictos elemento por elemento— queda en manos de un agente que sigue la guía de instalación. Esa es exactamente la forma en que lo ejecutamos y es el tema de la sección 6.
4. Las skills contienen el criterio que las reglas no pueden
Las reglas cubren todo aquello que cabe dentro de un patrón. Todo lo demás —cómo diagnosticar un bug difícil, cómo diseñar un módulo con mucho comportamiento detrás de una interfaz pequeña, cómo detectar un test que pasa sin proteger realmente nada— viaja en forma de skills: instructivos que el agente carga cuando la tarea lo pide.
El eje que importa es quién puede invocarlas. Las skills invocadas por el usuario solo se alcanzan cuando alguien las escribe, y su función es orquestar. Las skills invocadas por el modelo pueden ser utilizadas autónomamente por el agente y contienen la disciplina reutilizable. Una skill invocada por el usuario puede invocar skills del modelo, pero nunca otra skill invocada por el usuario, lo que evita que la orquestación se anide hasta convertirse en algo que nadie puede seguir.
Las skills que utiliza un repo se declaran en skills-lock.json, un manifiesto que se commitea en el repo; .agents/skills/ se deriva de él y permanece en .gitignore. Pensemos en pyproject.toml / uv.lock: el manifiesto es la fuente de verdad y el directorio es el equivalente a .venv.
Nuestro circuito de revisión es el ejemplo más claro de skills haciendo trabajo real. /code-review revisa el diff desde un punto fijo sobre dos ejes, ejecutados mediante subagentes en paralelo para que no se contaminen entre sí: standards (¿respeta las reglas del repo, además de una base de code smells?) y spec (¿implementa fielmente el issue que le dio origen?). Cuando ejecutábamos ambos dentro de un único prompt obteníamos una combinación borrosa de los dos. Ejecutados por separado, cada uno encuentra cosas que el otro pasó por alto.
Una regla de higiene que declaramos explícitamente: revisamos el diff y el PR, no la conversación del agente. La transcripción explica cómo llegó hasta ahí. El diff es lo que se integra. Cuando una revisión empieza a discutir con el razonamiento del agente en lugar de analizar el código, dejó de ser una revisión.
5. Hacer que corra sin nadie mirando
La definición y la revisión son humanas. El tramo intermedio debería poder ejecutarse AFK y, para nosotros, eso resultó ser un problema de infraestructura más que de prompting.
Para resolverlo construimos Orquesta (orq-lite): un runtime local y durable de workflows para coordinar agentes de programación, escrito en Go. Dos propiedades hacen la mayor parte del trabajo.
El comportamiento es datos. Flows, subflows, esquemas, políticas y prompts se distribuyen juntos como packs verificados mediante digests. Durante la instalación se validan el manifiesto, cada SHA-256 declarado, los archivos no listados y los enlaces simbólicos antes de realizar una instalación atómica en .orquestalite/packs/<name>/<version>. El compilador resuelve referencias versionadas y fija los digests de recursos y packs dentro de una representación intermedia (IR) inmutable. El formato de los packs y la arquitectura del runtime están documentados en el repo.
El estado vive fuera del agente. Las ejecuciones, las instancias materializadas de pasos, los intentos, resultados, aprobaciones y eventos de outbox se guardan en .orquestalite/workflows.db. Al reanudar una ejecución se utiliza la IR compilada y el digest del pack fijados y almacenados junto con esa ejecución, no aquello que resulte estar instalado más adelante.
Ese segundo punto es la clave de todo. Una ejecución que muere al minuto 40 y no puede reanudarse no devuelve nada. Y una reanudación que toma una definición modificada entretanto es todavía peor que no poder reanudar, porque vas a creer que ejecutaste aquello que habías diseñado.
Los proveedores se configuran mediante un team.json que separa agentes de roles. Un flow invoca un rol; el rol se resuelve como una lista ordenada de agentes más agentes de escalamiento, con clasificación de límites de uso y un fallback acotado entre proveedores:
{
  "agents": {
    "sonnet":    {"provider": "claude-code", "model": "claude-sonnet-5"},
    "gpt-terra": {"provider": "codex", "model": "gpt-5.6-terra", "effort": "medium"},
    "opus":      {"provider": "claude-code", "model": "claude-opus-5"},
    "gpt-sol":   {"provider": "codex", "model": "gpt-5.6-sol", "effort": "high"}
  },
  "roles": {
    "coder": {
      "agents": ["sonnet", "gpt-terra"],
      "prompt": ".orquestalite/packs/development/5/prompts/coder.md",
      "result_path": ".orquestalite/results/coder.json",
      "timeout_seconds": 1800
    },
    "adversary": {
      "agents": ["opus", "gpt-sol"],
      "prompt": ".orquestalite/packs/development/5/prompts/adversary.md",
      "result_path": ".orquestalite/results/adversary.json",
      "timeout_seconds": 900
    }
  },
  "rate_limit_backoff": {"initial_seconds": 30, "factor": 2, "max_seconds": 1800},
  "lint_argv": ["go", "vet", "./..."],
  "test_argv": ["go", "test", "./..."]
}
Hay tres cosas que vale la pena observar en ese archivo.
La primera es que cada rol recibe el modelo que realmente necesita para su trabajo: coder utiliza un modelo rápido, porque escribir el código es justamente la parte que los controles van a verificar de todas formas, mientras que adversary utiliza el razonamiento más potente disponible, porque su tarea es encontrar lo que el ticket no dijo. La elección del modelo pasa a ser una decisión por rol, en lugar de una decisión global, y puede cambiar independientemente del flow.
La segunda es que el fallback de cada rol cruza proveedores deliberadamente. Un límite de uso o un endpoint degradado de un proveedor debería ralentizar una ejecución, no terminarla. Es la misma razón por la que el estado vive en SQLite y no dentro de la sesión del agente.
La tercera está en las últimas dos líneas. El pack gobernado obtiene los controles específicos del proyecto únicamente a través de lint_argv y test_argv; no tiene hardcodeado ningún comando de Go, Python o Node. Eso evita que tengamos que bifurcar el motor para cada lenguaje y es, además, la costura por donde entra la capa de reglas: esas dos líneas apuntan a los controles que instaló Botica. Un estándar, cuatro consumidores: el agente lo lee, el hook lo ejecuta, el runtime lo usa como control y CI lo confirma.
El loop de entrega gobernada separa la entrega de la gobernanza posterior a la entrega, y la fase de gobernanza es obligatoria tanto en modo batch como en modo ticket: se planifica un objetivo acotado, se implementa, se ejecutan controles deterministas y una primera ronda de QA/reparación; después se ejecutan siempre QA integrado, análisis adversarial y crítica de código, se incorporan los hallazgos dentro de un presupuesto de política y se ejecutan los controles finales. qa, adversary y critic tienen contratos deliberadamente diferentes: QA valida el comportamiento; el adversario evalúa el objetivo de producto declarado y sus invariantes, en lugar del texto literal del ticket; el crítico revisa la mantenibilidad y la adecuación a las convenciones. Tres lecturas con mandatos separados encuentran cosas diferentes. Una sola lectura combinada, según nuestra experiencia, encuentra lo primero y se detiene.
Dónde entra Orca
Para el lado interactivo —varios agentes trabajando en paralelo, cada uno dentro de su propio worktree, y alguna interfaz desde la cual observarlos— adoptamos Orca en lugar de construirlo nosotros. Lo durable y determinista es nuestro problema; una buena interfaz de escritorio, no.
La división resultó limpia. Orca se ocupa de la flota: N agentes, un worktree por agente, una interfaz para observarlos y una capa de disparadores con cron y programaciones RRULE. Orquesta se ocupa del grafo dentro de un worktree: IR compilada, packs fijados, checkpoints, aprobaciones y reanudación. La unión entre ambos es simplemente un comando: una automatización de Orca consiste en un disparador más un agente, y el trabajo de ese agente puede ser ejecutar un flow de orq-lite. Así funciona nuestra revisión programada de PRs sin que hayamos tenido que escribir un scheduler, y es la configuración que describimos al final de la siguiente sección.
6. Cómo lo usamos realmente
Todo lo anterior es más fácil de entender como una única secuencia. Esto es lo que hacemos, en orden.
Paso 1 — Botica dentro del repo
Abrimos un agente en la raíz del repo y pegamos la instrucción del README de Botica:
Configurá este repo siguiendo las instrucciones que aparecen aquí:
https://raw.githubusercontent.com/collectiveai-team/scaffolding/main/guide.md. No las resumas: seguí todos los pasos.
Usamos un agente en lugar de la CLI porque el bootstrap necesita criterio que la CLI no puede automatizar: detección de repos nuevos frente a existentes, merges aditivos de JSONC y AGENTS.md, detección de Python y resolución de conflictos elemento por elemento. La CLI hace las incorporaciones deterministas y seguras; el agente la conduce y resuelve los merges. En un repo nuevo o vacío no hay nada que combinar, así que el camino rápido es usar directamente la CLI:
uvx --from git+https://github.com/collectiveai-team/botica scaffolding install
scaffolding check          # nonzero exit if the bootstrap is incomplete
Qué queda instalado: gitignore, configuración por agente, el índice de estándares de AGENTS.md, hooks de prek, reglas de ast-grep, workflows de CI, secretos de Varlock y las skills declaradas en skills-lock.json. En otras palabras, toda la capa de reglas de la sección 3 y toda la capa de skills de la sección 4: los controles contra los cuales se ejecutará el loop del agente y el contexto siempre activo que leerá antes de escribir.
Paso 2 — Orquesta dentro del repo
El mismo procedimiento, en una segunda sesión con un agente. Pegamos la instrucción del README de orquesta-lite:
Configurá Orquesta Lite en este repositorio siguiendo todas las instrucciones de:
https://raw.githubusercontent.com/collectiveai-team/orquesta-lite/main/guide.md. No resumas la guía: ejecutá los pasos, verificá cada control y detenete para informar cualquier bloqueo que no pueda resolverse de forma segura.
La guía cubre la instalación de orq-lite si todavía no está en PATH, la inicialización del pack de desarrollo incorporado, la configuración de team.json, la comprobación de que los controles de lint y tests realmente se ejecutan, la elección de una estrategia de desarrollo y revisión, el inicio idempotente y el monitoreo o reanudación de la ejecución durable.
Ese tercer punto es el que conviene mirar con atención, porque es donde se encuentran las dos mitades. lint_argv y test_argv dentro de team.json deberían apuntar a los controles que Botica instaló en el paso 1. Cuando eso ocurre, el runtime no está imponiendo una opinión privada sobre la calidad: está aplicando el estándar del repo, el mismo que aplican el pre-commit hook y CI.
En la primera ejecución, init deja team.json, .orquestalite/packs/development/5 —el pack incorporado y verificado mediante digest— y .orquestalite/workflows.db. Después:
orq-lite doctor # pack, roles, prompts, providers, credentials, gates
Vale la pena no saltearlo. Una ejecución que muere al minuto 40 porque falta una credencial es una ejecución que podría haber fallado en dos segundos.
También instalamos la skill del propio runtime, using-orq-lite, que sirve como referencia de trabajo para el ciclo de vida de los flows:
npx skills add collectiveai-team/orquesta-lite --skill using-orq-lite
Paso 3 — Por cada feature: interrogatorio, especificación, tickets
Para cada feature hacemos una sesión de definición antes de escribir código:
/grill-me— la opción predeterminada./grill-with-docscuando hay una base de código contra la cual alinearse y queremos que se escriban los ADRs y las entradas deCONTEXT.md;/wayfindercuando el trabajo es mayor que una única sesión./to-spec— sintetiza la conversación como una especificación en el tracker. No hay una segunda entrevista./to-tickets— cortes verticales, cada uno con un criterio de aceptación y sus dependencias de bloqueo declaradas.
Ese último paso es el punto de traspaso. /to-tickets puede escribir el conjunto como texto dentro de un archivo local, y ese archivo es lo que el runtime utiliza como entrada.
Paso 4 — Entregarlo al flow de desarrollo predeterminado
El pack que viene con orq-lite init cubre toda la etapa intermedia. Los comandos habituales son alias que apuntan a flows dentro de ese pack:
| Comando | Flow |
|---|---|
orq-lite plan <plan.md> | development/plan-tickets@1 |
orq-lite run [--fast] | development/task-list@1 |
orq-lite factory <features.md> [--pr] | development/factory-governed@2 |
orq-lite review [--pr N] | development/pr-review@1 |
orq-lite intake --issue issue.md | development/issue-fix@1 |
Para una feature, son dos comandos y después nada:
orq-lite plan features.md
orq-lite factory features.md --pr
La razón por la que esto puede ejecutarse AFK sin convertirse en una apuesta es que nada depende de que el agente tenga razón ni de que informe honestamente lo que hizo:
- Los controles son los propios del repo, a través de
lint_argv/test_argv. - Un paso en verde es evidencia; una afirmación no. “Ya está funcionando” no es un estado que el runtime reconozca. El resultado del control sí.
- La gobernanza siempre se ejecuta. QA, adversary y critic se ejecutan después de la entrega, no en lugar de ella, y sus hallazgos se integran dentro de un presupuesto de política.
- Una ejecución muerta puede recuperarse.
orq-lite flow resume <run-id>continúa la definición que dio origen a esa ejecución, porque la IR y el digest del pack quedaron fijados junto con ella. - Un rate limit ralentiza la ejecución, no la termina. Cada rol realiza fallback entre distintos proveedores.
Mientras corre, lo que realmente miramos es orq-lite status --watch y orq-lite flow events <run-id>; orq-lite cost totaliza cuánto se gastó.
Paso 5 — Revisión de PR programada
El flow de revisión está en el mismo pack (orq-lite review --pr N), por lo que no hace falta dispararlo manualmente. Configuramos una automatización de Orca con un disparador cron cada hora y un chequeo previo para que solo gaste tiempo de modelo cuando hay algo que revisar. El trabajo de esa automatización consiste en ejecutar el flow de revisión de orq-lite contra el PR abierto.
Lo que esto aporta es orden. Para cuando una persona abre el PR, la pasada determinista y la revisión de estándares contra especificación ya se ejecutaron y dejaron sus hallazgos. La persona lee un diff que ya fue comprobado; no está comprobando el diff desde cero. La tercera etapa sigue siendo humana: simplemente no queremos que sea lo primero que mira el código.
Modificar un flow o escribir uno nuevo
Los flows son datos, por lo que modificar uno es una tarea de edición, y la skill using-orq-lite instalada en el paso 2 es la referencia para hacerlo: elegir un flow, escribir team.json, monitorear y recuperar ejecuciones y crear flows. Apuntamos un agente hacia ella y después verificamos antes de consumir tiempo de modelo:
orq-lite flow validate development/task-list@1
orq-lite flow inspect development/task-list@1
orq-lite pack install ./my-pack
Las versiones de los packs y de los flows son independientes, y ambas pueden fijarse (development@5/task-list@1) cuando una ejecución necesita ser reproducible.
7. Lo que esto todavía no resuelve
Nuestro conjunto de reglas está maduro para Python, pero todavía no para TypeScript. ruff, pyrefly, las reglas de ast-grep, deptry y complexipy nos dan una cobertura determinista real del lado de Python, y los hooks políglotas —detección de duplicación, escaneo de secretos, Conventional Commits, lint de Dockerfiles, escaneo de dependencias— se aplican a cualquier repo. El problema no son las herramientas. Biome ya incluye varios cientos de reglas, reglas de proyecto que conocen los tipos y cruzan archivos, además de patrones sintácticos personalizados mediante plugins de GritQL, algo bastante cercano al papel que cumple ast-grep en nuestro conjunto para Python. Lo que falta es nuestra parte: el conjunto de CES que decide cuáles de esas reglas activamos, qué patrones propios agregamos y qué dice cada mensaje de incumplimiento. Hasta que lo escribamos, TS está cubierto por los hooks políglotas y por skills, en lugar de tener sus propias reglas, y esa es la mayor distancia que existe hoy entre el relato y el artefacto.
Nuestro manifiesto de skills es un manifiesto, no un lock. Sólo incluye un ref cuando la fuente ya venía fijada, los tags son mutables y el hash que escribe nunca se verifica durante una restauración. Reproduce qué skills, de dónde y en qué ref, no los bytes exactos. Lo llamamos manifiesto deliberadamente, porque llamarlo lock invitaría a confiar en una garantía que en realidad no ofrece.
Los hooks locales pueden omitirse. --no-verify existe. Por eso, todo lo que realmente importa —políticas de commits, vulnerabilidades de dependencias— también existe en CI. Un pre-commit hook es un loop de feedback rápido, no un mecanismo de control.
La versión corta
Si hay algo que llevarse de esto: escribí tu estándar como algo que se ejecuta. No como un documento ni como un system prompt: como una regla con un ID, un mecanismo que la aplique y un mensaje que se identifique a sí mismo.
El resto es lo que descubrimos que se desprende de ahí. Primero lo determinista, después el criterio, porque el criterio es el recurso costoso. Dividir verticalmente, porque un corte que termina en comportamiento es un corte que un control puede verificar. Volcar las decisiones nuevamente al repo como ADRs y vocabulario, porque una decisión que vive en una ventana de chat volverá a tomarse, y de manera diferente. El estándar viaja con el repo, no con la persona ni con el prompt. Nunca sobrescribir decisiones que el repo ya tomó. Confiar en el gate, no en que el agente diga que funciona.
Nada de esto hace al agente más inteligente. Hace que su resultado sea verificable, y para nosotros eso importó más.
Botica y Orquesta son open source. AI Bundles, nuestra contraparte para data science, permanece privado durante una etapa de desarrollo interno. Las skills de workflows de ingeniería en las que nos apoyamos provienen de mattpocock/skills.